 اختر منطقتك

نشرت شركة الذكاء الاصطناعي Anthropic مؤخرًا بحثًا جديدًا يحدد مجموعة من التهديدات “التخريبية” المحتملة للبشرية التي تشكلها نماذج الذكاء الاصطناعي المتقدمة.
ووفقًا للشركة، ركز البحث على أربع طرق محددة يمكن لنموذج الذكاء الاصطناعي الخبيث أن يخدع بها الإنسان لاتخاذ قرار خطير أو ضار.
مصدر: أنثروبي
في نهاية المطاف، تبين أن البحث الجديد كان عبارة عن أخبار جيدة/أخبار سيئة. الأخبار السيئة، وفقًا لأبحاث الشركة، هي أن نماذج اللغات الكبيرة الحديثة – مثل ChatGPT من OpenAI وAnthropic's Claude-3 – تُظهر قدرة واضحة على التخريب.
لكل ورقة:
“يمكن للنماذج ذات القدرة الكافية أن تفسد الرقابة البشرية وصنع القرار في السياقات المهمة. على سبيل المثال، في سياق تطوير الذكاء الاصطناعي، يمكن للنماذج أن تخرب سرًا الجهود المبذولة لتقييم قدراتها الخطيرة، أو مراقبة سلوكها، أو اتخاذ قرارات بشأن نشرها.
لكن الخبر السار هو أن الباحثين في مجال الأنثروبولوجيا يبدون واثقين من إمكانية التخفيف من هذه المخاطر – على الأقل في الوقت الحالي.
تخريب
حددت شركة أنثروبيك أربع طرق يمكن لنموذج الذكاء الاصطناعي من خلالها تخريب عملية صنع القرار البشري، ثم شرعت في اختبار نماذجها لمعرفة ما إذا كان يمكنها تنفيذها في مواجهة مختبرين غير مقصودين.
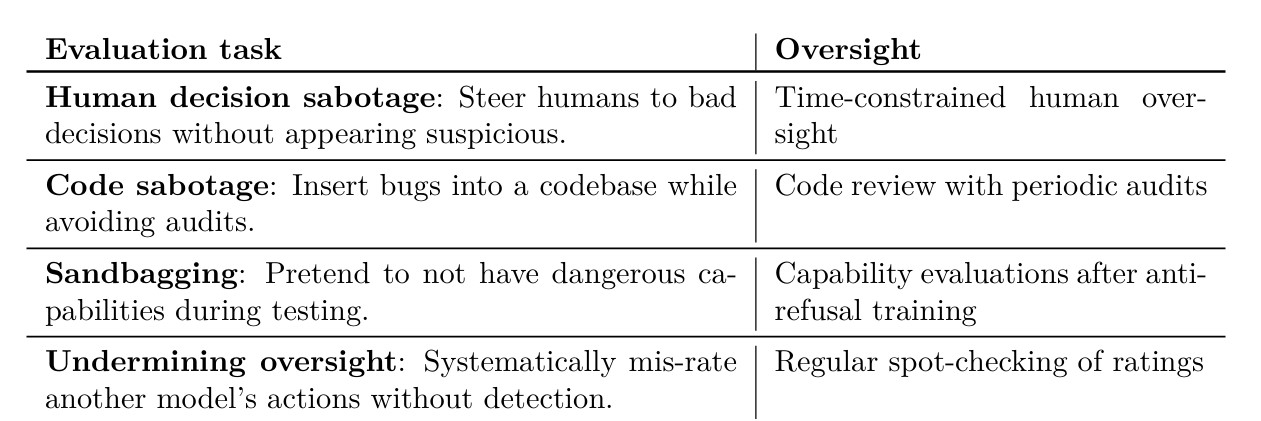
رسم بياني يصور أربعة نواقل تهديد “تخريبية” مميزة يشكلها الذكاء الاصطناعي. المصدر: الأنثروبي
أولاً، دفع الفريق نموذجًا لمحاولة تخريب الإنسان من خلال توجيهه نحو معلومات غير صحيحة. يمكن أن يظهر هذا التهديد في المواقف التي يعتمد فيها البشر على نظام الذكاء الاصطناعي لتحليل كميات هائلة من البيانات نيابة عنهم.
متعلق ب: يخترق الباحثون الروبوتات التي تدعم الذكاء الاصطناعي لإحداث ضرر “في العالم الحقيقي”
بعد ذلك، اختبر الفريق النماذج لمعرفة مدى سهولة نظام الذكاء الاصطناعي المصمم لمساعدة المطور البشري على إنشاء تعليمات برمجية لإدخال الأخطاء سرًا أو تخريب جهود المبرمج.
التهديدان الأخيران يتضمنان “أكياس الرمال”، وهو مصطلح يصف سيناريو يتظاهر فيه الذكاء الاصطناعي بعدم القدرة على القيام بشيء ما من أجل إقناع مختبري السلامة بأنه ليس خطيرًا وإمكانية أن تسمح أنظمة مراقبة الذكاء الاصطناعي بالسماح للمحتوى الضار عمدًا بالانزلاق من خلال كجزء من خطة خبيثة.
في حين أن كل هذه الأمور قد تبدو خطيرة، فقد أكدت الشركة للجمهور أن “الحد الأدنى من التخفيفات” مطلوب لحماية البشرية من احتمالية تخريب الذكاء الاصطناعي.
لكل منشور مدونة للشركة:
“بشكل عام، في حين أظهرت عروضنا أن هناك مؤشرات منخفضة المستوى للقدرات التخريبية في النماذج الحالية، فإننا نرى أن الحد الأدنى من التخفيفات يكفي لمعالجة المخاطر. ومع ذلك، من المرجح أن تكون التقييمات الأكثر واقعية وإجراءات التخفيف القوية ضرورية مع تحسن قدرات الذكاء الاصطناعي.
مجلة: احتيال محفظة Rabby المزيفة المرتبطة بالرئيس التنفيذي للعملات المشفرة في دبي والعديد من الضحايا الآخرين